Domain steuervergünstigungsabbaugesetz.de kaufen?
Wir ziehen mit dem Projekt
steuervergünstigungsabbaugesetz.de um.
Sind Sie am Kauf der Domain
steuervergünstigungsabbaugesetz.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain steuervergünstigungsabbaugesetz.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
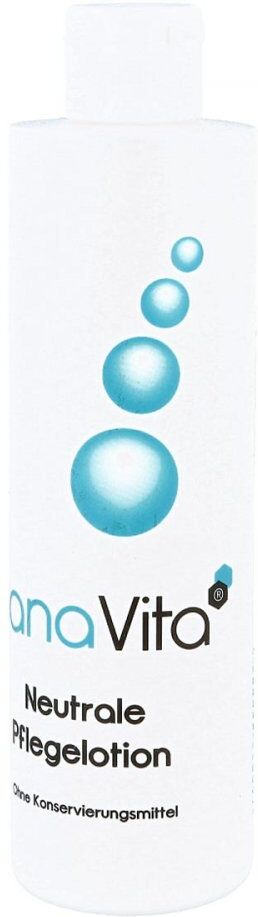
Sana Vita Neutrale Pflegelotion 500 MLProdukteigenschaften: SANA VITA Neutrale Pflegelotion Zur Pflege von trockener bis sehr trockener Haut. Produktbeschreibung: Basispflegelotion mit 30% Lipidanteilen für trockene bis sehr trockene Haut. Anwendung: 1 - 2 mal täglich und bei Bedarf auf die betroffenen Stellen auftragen. Geeignet für alle Altersgruppen. Warnhinweis: Nicht in die Haare bringen. Das Produkt lässt sich schwer aus den Haaren entfernen. Ingredients: Aqua, Caprylic/Capric Triglyceride, Isopropyl Palmitate, Isopropyl Myristate, Butylene Glycol, Glycerin, Zinc Sulfate, Polyglyceryl-4 Diisostearate/Polyhydroxystearate/Sebacate, Polyglyceryl-3 Oleate, Glyceryl Caprate, Hydrogenated Castor Oil, Cera Alba, Diisostearoyl Polyglyceryl-3 Dimer Dilinoleate, Tocopheryl Acetate, Bisabolol. Quelle: https://sana1.de Stand: 08/202420,38 €*Versand: 4,70 €Sichere Weiterleitung zum Anbieter

-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Sana Vita Neutrale Pflegelotion 500 MLProdukteigenschaften: SANA VITA Neutrale Pflegelotion Zur Pflege von trockener bis sehr trockener Haut. Produktbeschreibung: Basispflegelotion mit 30% Lipidanteilen für trockene bis sehr trockene Haut. Anwendung: 1 - 2 mal täglich und bei Bedarf auf die betroffenen Stellen auftragen. Geeignet für alle Altersgruppen. Warnhinweis: Nicht in die Haare bringen. Das Produkt lässt sich schwer aus den Haaren entfernen. Ingredients: Aqua, Caprylic/Capric Triglyceride, Isopropyl Palmitate, Isopropyl Myristate, Butylene Glycol, Glycerin, Zinc Sulfate, Polyglyceryl-4 Diisostearate/Polyhydroxystearate/Sebacate, Polyglyceryl-3 Oleate, Glyceryl Caprate, Hydrogenated Castor Oil, Cera Alba, Diisostearoyl Polyglyceryl-3 Dimer Dilinoleate, Tocopheryl Acetate, Bisabolol. Quelle: https://sana1.de Stand: 08/202420,38 €*Versand: 4,70 €Sichere Weiterleitung zum Anbieter
-
Adam, Hermann: FinanzpolitikFinanzpolitik , Über Veränderungen in seinen Ausgaben und Einnahmen greift der Staat in den Wirtschaftskreislauf ein: Er betreibt Finanzpolitik. Aber wie setzt die Politik Steuern und Staatsausgaben zur Lenkung der Wirtschaft ein? Welche Auswirkungen hat das auf die Verteilung von Einkommen und Vermögen? Und nicht zuletzt: Welche Möglichkeiten und Grenzen gibt es für die Staatsverschuldung? Fundiert erläutert Hermann Adam die Instrumente der Finanzpolitik und beschreibt die Entwicklung von Steuereinnahmen, Staatsausgaben und Staatsverschuldung seit dem Zweiten Weltkrieg. Er diskutiert aktuelle Ideen zur Steuerreform und die dahinterstehenden ökonomischen Interessen sowie die Schwierigkeiten, im föderalen System der Bundesrepublik zu finanzpolitischen Entscheidungen zu kommen. "'Finanzpolitik' ist ein äußerst gelungenes Einführungswerk, das mit Präzision, Klarheit und hoher Relevanz besticht" (Stella Wasenitz, Marie J.M. Heijens, in: Politische Vierteljahresschrift, 7.2.2025). "Ohne in akademische Nischendiskurse abzudriften, überzeugt der Band durch sein Gespür dafür, worauf es ganz grundsätzlich für ein Verständnis finanzpolitischer Zusammenhänge und Kontroversen ankommt" (Hendrik Küpper, in: perspektivends 42/1). "Insbesondere Leser*innen, die sich einen schnellen, aber dennoch prägnanten Überblick über die einzelnen Aspekte der deutschen Finanzpolitik verschaffen wollen, ist das Buch sehr zuempfehlen. Und auch im Rahmen der akademischen Lehre kann es sehr sinnvoll eingesetzt werden" (Julia Kieswo-Udwari, in: Portal für Politikwissenschaft, 24.7.2025). , Vergaserteile > Ansaug- & Kraftstoffsysteme , Erscheinungsjahr: 20241031, Titel der Reihe: Politik verstehen##, Autoren: Adam, Hermann, Seitenzahl/Blattzahl: 217, Abbildungen: 33 Abbildungen, 26 Tabellen, Themenüberschrift: POLITICAL SCIENCE / Political Economy, Keyword: Staatseinnahmen; Staatshaushalt; Steuern, Fachschema: Politik / Politikwissenschaft~Politikwissenschaft~Politologie~Wirtschaftspolitik, Fachkategorie: Wirtschaftspolitik, politische Ökonomie, Warengruppe: TB/Politikwissenschaft, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 202, Breite: 140, Höhe: 10, Gewicht: 288, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft,24,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.